
前面三篇,我們分別從不同角度檢查了 RAG 的檢索結果:Context Precision 看找回來的資料準不準,Context Recall 看必要資料有沒有漏掉,Context Entities Recall 則進一步看關鍵實體有沒有完整找回。但這裡還剩下最後一個問題:如果 Context 裡混入了無關資訊,系統還能不能穩定作答?這就是今天要介紹的指標,Noise Sensitivity,用來觀察系統面對干擾資訊時的穩定程度。
在 RAG 裡,可以把與當下問題無關、甚至可能造成誤導的 Context 視為一種雜訊。假設使用者問「特休一天需要提前幾天申請?」,真正有用的內容是「特休需要提前三天向主管申請」,但 Retriever 同時找回了加班申請規定、員工旅遊辦法、薪資計算方式這類與問題完全無關的片段,這些內容就是所謂的 Noise。
先設想一個乾淨的情境:如果 Context 裡只有真正相關的資訊,語言模型自然可以根據這段內容產生正確答案。但如果在這段乾淨的 Context 之外,又混入了一堆無關內容,我們真正想觀察的是,加入雜訊前後,回答品質改變了多少。如果雜訊增加了,但答案依然維持穩定,代表系統即使面對干擾,仍然能夠抓住真正重要的內容;反過來,如果只是加入少量無關資訊,答案就開始偏離原本正確的方向,就代表系統比較容易受到雜訊干擾。這正是 Noise Sensitivity 想捕捉的問題。
這個指標之所以重要,是因為真實世界的知識庫幾乎不可能完全乾淨。假設一間公司的知識庫裡有數萬份文件,即使 Retriever 設計得再好,也很難保證每一次檢索回來的 Context 都完全不含任何無關內容。因此實務上真正該問的問題,不是「系統能不能永遠找到 100% 完美的 Context」,而是「當 Context 不完美時,系統還能不能穩定回答」。這也是為什麼 Noise Sensitivity 值得獨立成一個評測面向——它測的不是 Context 本身好不好,而是系統在 Context 不夠乾淨時,還撐不撐得住。
具體要怎麼觀察這件事,可以透過一組簡單的對照實驗。先只提供真正相關的內容,例如「特休需要提前三天向主管申請」,得到一個基準答案;接著在這段內容之外,加入少量無關資訊,例如混入一段加班申請規定,再看看答案是否依然維持「三天」這個正確結果;最後再加入更大量的雜訊,同時混入員工旅遊辦法、薪資計算方式、辦公室管理規範等好幾段完全不相關的內容,觀察答案是否開始出現偏差、答非所問,或是把不相關的規定誤植進答案裡。把這三種情況的結果放在一起比較,就能看出隨著雜訊增加,系統的回答究竟穩不穩定。
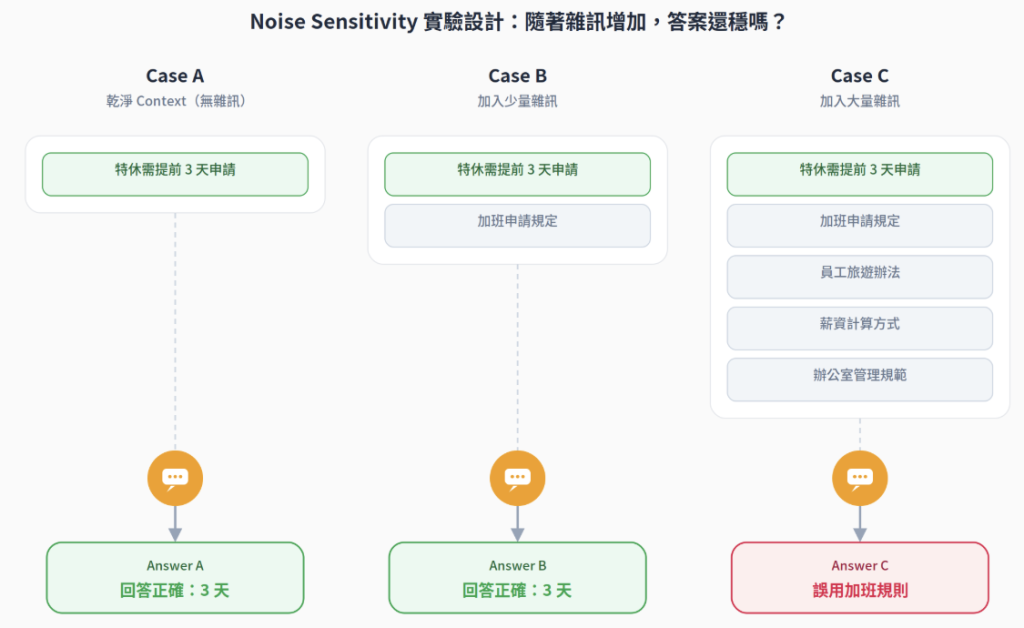
這裡也容易和 Context Precision 搞混,因為兩者都跟「無關資訊」有關,但觀察的角度並不相同。Context Precision 問的是「找回來的 Context 本身有多精準」,關心的是 Retriever 交出來的這批內容裡,相關與不相關的比例;Noise Sensitivity 問的則是「當 Context 裡確實存在雜訊時,系統的回答會受到多大影響」,關心的是語言模型面對雜訊時的抵抗力。簡單說,前者檢查的是 Context 本身乾不乾淨,後者檢查的是系統怕不怕雜訊——兩者雖然都圍繞著雜訊打轉,問的卻是完全不同層次的問題。
到這裡,我們已經完成了檢索階段的四個評測指標:Context Precision 檢查準不準,Context Recall 檢查漏不漏,Context Entities Recall 檢查關鍵實體齊不齊,Noise Sensitivity 檢查面對雜訊穩不穩。這四個指標合起來,會構成我們判斷一次檢索結果好壞的完整框架,也讓我們對 RAG 評測有了新的理解:評測不是跑一次、得到一個分數就結束,而是要能透過分數回頭定位問題——Context Precision 偏低,該檢查的是 Retriever 或 Reranker;Context Recall 偏低,該檢查的是 Chunking、Embedding 或 Top-K 的設定;Context Entities Recall 偏低,該檢查的是關鍵資訊是不是在 Chunking 時被拆散;Noise Sensitivity 偏高,則該檢查系統對無關內容的抵抗力夠不夠。這才是評測真正的價值所在——不只是知道分數是多少,而是知道問題可能出在哪一個環節。
不過,即使這四項指標都表現良好,也只能說明我們提供給語言模型的 Context 品質不錯,還不能保證語言模型一定會產生正確答案。因為 RAG 還有下一個階段:Context 交給語言模型之後,模型有沒有正確理解、有沒有忠實使用這些內容、產生的答案是否正確,又是另一組完全不同的問題。下一篇,我們會先把 Day12 到 Day15 這四個檢索評測指標做一次整合回顧,再往後就要正式從檢索品質,走向回答品質的評測。


 iThome鐵人賽
 看影片追技術